异质集成路线:MicroLED 单通道跑到 10 Gb/s,为什么阵列还没一起提速?
用 Avicena 的原始带宽、BER 和能耗图,拆解 10 Gb/s 单器件到并行阵列之间的接收器、均衡、串扰与功耗限制。
MicroLED 光互连 · 技术路线 01。本文讨论“蓝宝石上生长 GaN MicroLED,再转移到硅驱动电路,并与硅接收器配合”的路线。通过一组公开实验,区分发光器件、接收电路与并行链路的限制。
看到一项成果同时出现“300 个 MicroLED”“单通道 10 Gb/s”和“约 1 pJ/bit”,很容易在脑中拼出一个规格:3 Tb/s、低功耗、整阵列同时运行。
但在 Avicena 的 2025 年 CS MANTECH 论文中,这些数字来自不同实验配置。把它们拆开,并不会削弱研究价值,反而能看见下一步真正要解决的工程问题:发光器件的速度已经跑在部分集成电路前面,而把单器件能力搬进阵列,需要重新支付驱动、接收、串扰和热管理的成本。
1. 这条路线把哪些部分分开优化?
论文里的 MicroLED 先在图形化蓝宝石衬底上生长,制作成 p、n 接触在同侧的横向器件,再通过激光剥离与转移键合,放到硅 ASIC 或用于测试的蓝宝石基板上。发光与逻辑电路可以各用合适的工艺,而不必让 GaN 外延直接承受 CMOS 已完成电路的工艺约束。[1,PDF 第 1–2 页]
这里的“异质集成”有两层意思:GaN 发射器与硅驱动电路集成;链路另一端采用硅光电探测器与接收电路。它没有要求发射器和探测器使用同一套发光外延。
文章描述的钥匙孔形器件,大侧外轮廓约 12 μm,但电流注入区域约为直径 7 μm 的内圆,发光面积约 40 μm²。外轮廓、注入面积和阵列间距是三个不同的量:计算电流密度要用有效注入面积,计算带宽密度则要考虑完整通道占用的面积,不能都用“12 μm”代替。
横向结构让同侧接触与转移、互连方式相互配合;但接触电阻、走线寄生、出光和散热仍需共同优化。这里不宜作“横向只能做 Demo、垂直必然适合量产”的二分判断。器件剖面是设计变量,可靠性、良率与成本必须由具体流程和统计数据来回答。
2. 约 2 GHz 带宽,为什么能传 10 Gb/s?
先看作者给出的带宽原图。
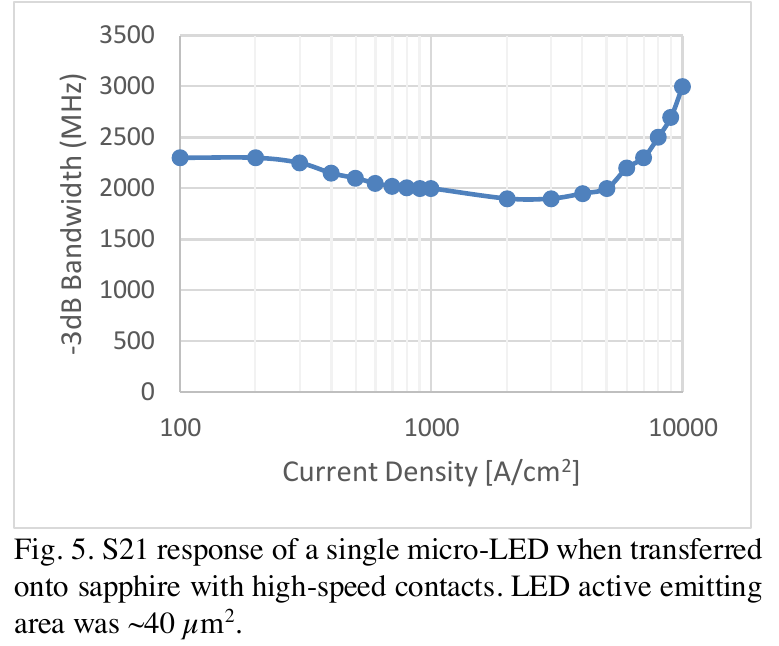
这条曲线的重要信息不是最高点,而是很宽的电流范围内,器件带宽处在约 2 GHz 量级。把注入电流继续往上推,并没有处处换来等比例的速度提升。曲线也并非单调上升,所以不能从它抽象出“电流翻倍,带宽就翻倍”的规律。
−3 dB 带宽是频率响应的一个位置,不是一道超过它就完全没有信号的墙。若只用单极点低通建立直觉,其幅度响应是:
|H(f)| = 1 / √[1 + (f/fc)²]。
以 fc = 2 GHz、f = 5 GHz 为例,幅度约为低频值的 0.371,按 20 log₁₀ 换算约为 −8.6 dB。这个数字是本文的简化计算,不是对原图的拟合。它表示高频分量被明显压低,而不是消失。
10 Gb/s NRZ 的符号率为 10 GBd,奈奎斯特频率为 5 GHz,但真实脉冲和接收判决不能只用这一个频点描述。高频分量被削弱会拖慢边沿、增加码间干扰;均衡可以重新分配频谱,使判决时刻更容易区分 0 和 1,代价则是驱动摆幅、噪声容限、功耗或实现复杂度。
这正是原实验里不能省略的条件:单器件通过高速 GSG 接触、外部交流耦合的 50 Ω 驱动测试,并使用一抽头 FIR 均衡器。作者报告了 10 Gb/s 下约 10⁻¹⁰ 的 BER 和相应眼图;“看到最高 12 Gb/s 的清晰眼图”则是另一层证据,不能自动补成同样 BER、同样能耗的完整规格。[1,第 3–4 页]
因此,器件提速至少有三条路径,作用点不同:
| 路径 | 改变什么 | 需要验证的代价 |
|---|---|---|
| 优化外延与量子阱 | 改变载流子复合动力学,改善本征响应 | 同一工作点下的光功率、效率、热与可靠性 |
| 优化接触、尺寸和互连 | 减少部分电阻、电容和布线限制 | 接触电阻可能随缩小而上升,光子数与装配空间也会变化 |
| 驱动预加重/均衡 | 补偿链路中的频率依赖衰减 | 峰值电流、摆幅、噪声、码型依赖和电路能耗 |
测到更大的带宽,并不直接告诉我们是哪一项改善了。要定位原因,需要在相同偏置、温度和接收链下比较,并去除测试夹具与参考接收器的影响。
3. 三种实验,不要拼成一种规格
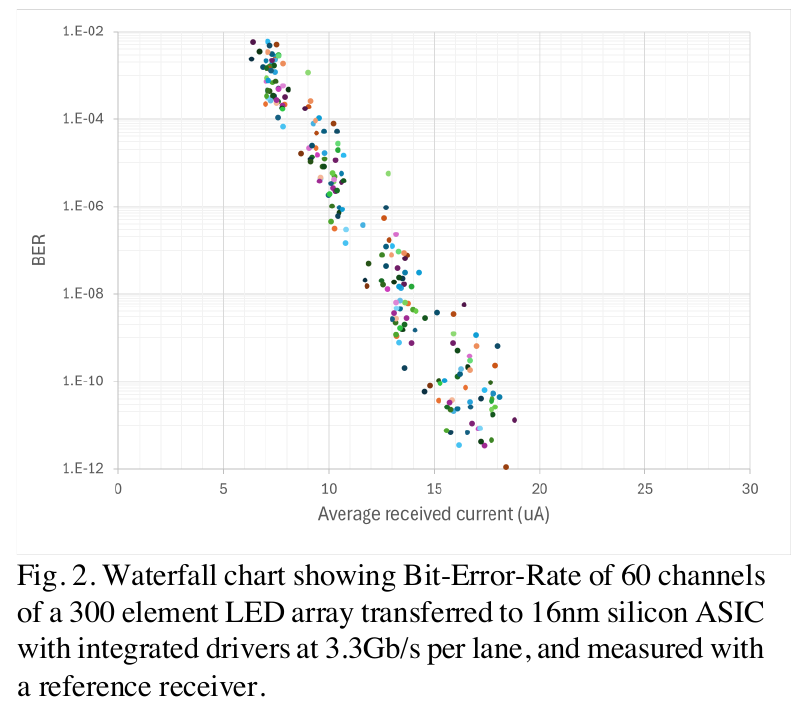
这张图能回答的是:把不同发射通道逐个接入同一参考接收链,BER 随接收光电流怎样变化,各通道之间有多少分散。它不能单独回答“300 条通道全开时,是否保持同样的接收门限”。
接着看第二张原图。
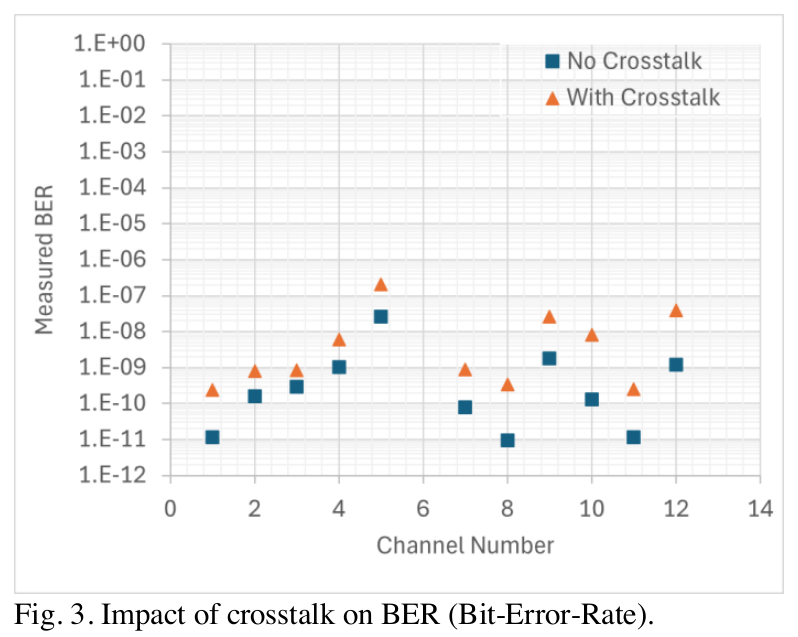
作者明确说明:因为这组定制探测阵列和集成 TIA 的性能弱于参考接收链,串扰实验降到了 2.5 Gb/s。图中的三角标记通常高于对应方形,提示其他通道工作后 BER 会变化;但不能将两图之间的差异全部解释为串扰,因为接收器、速率和实验条件也变了。
把证据并列,真正的工程进展就清楚了:
| 实验层次 | 速率与对象 | 能说明什么 | 不能说明什么 |
|---|---|---|---|
| 发射阵列逐通道表征 | 60 条被测通道,3.3 Gb/s,每次一条 | 通道一致性与参考接收链下的 BER | 全阵列同时开启的同速率结果 |
| 集成链路串扰实验 | 约十余条被测通道,2.5 Gb/s,其余通道作为干扰源 | 并行开启对实际集成链路的影响 | 所有通道、全码型、全温度下的认证 |
| 高速单器件实验 | 单通道 10 Gb/s,外部驱动与均衡 | 器件支持更高速传输的可能性 | 300 条同速率、同能耗、同时运行 |
论文把 300 × 10 Gb/s = 3 Tb/s 作为可扩展潜力。乘法成立,但原文结论也说明,阵列实验是在更低速率下完成的。产品级总吞吐还要扣除时钟、控制、冗余与编码开销,并验证真正同时工作的通道数。
4. “约 1 pJ/bit”到底花在哪一段?
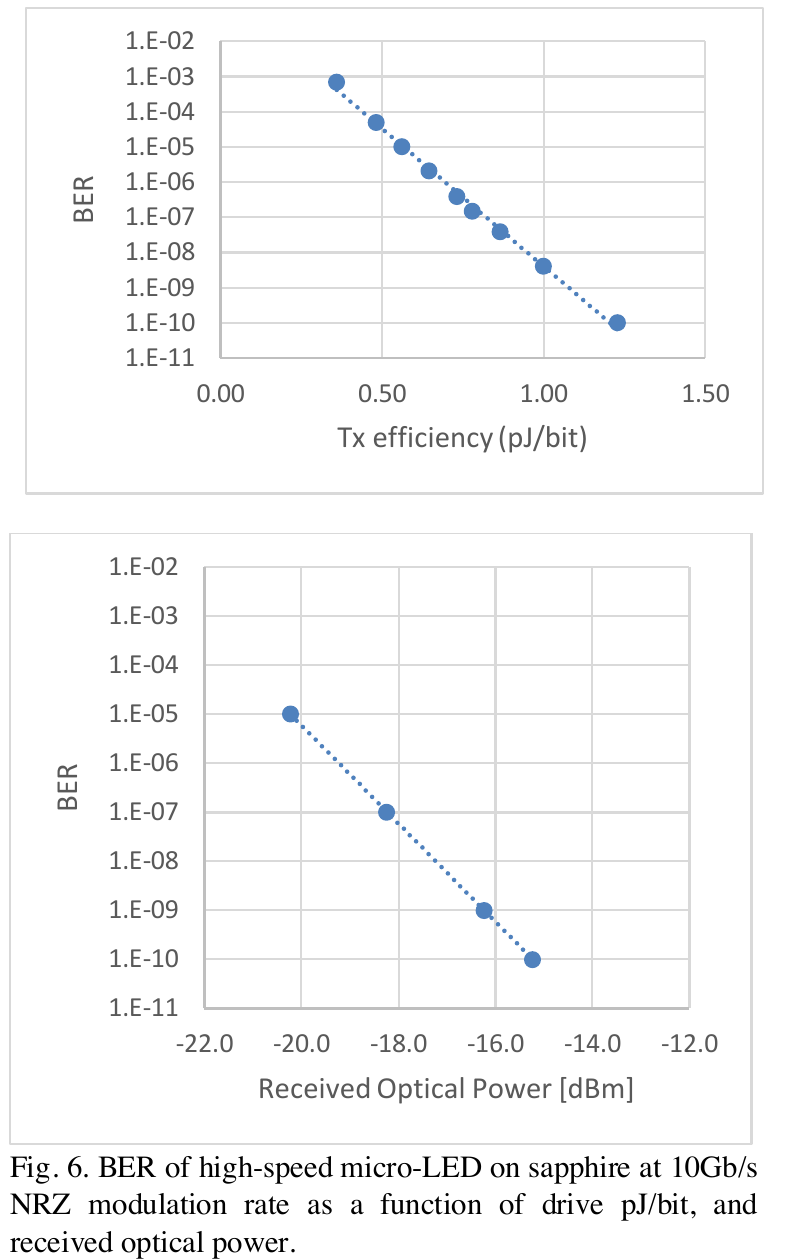
图中降低 BER 需要更多发射能量或更高接收光功率。这是重要的设计权衡,但不能从上方的能耗图得到整个系统的电源预算。
先看一个独立的直流工作点。论文给出 1.5 mA、4.4 V 下,积分球测得光输出约 80 μW。由此可算得输入功率约 6.6 mW,电光转换效率约 1.2%。这只是该点的直流计算;既不是高速调制时的完整能耗,也不等于耦合进光纤后的功率。把它直接除以另一项实验的 10 Gb/s,会混用两个工作条件。
真正比较路线,需要统一分母和边界:
Elink =(发射端、接收端、接口、时钟、控制和电源转换的总功率)÷ 对应方向上的有效载荷速率。
如果把双向功耗放在分子,分母也要用双向有效吞吐;空闲、部分通道工作和满载应分别记录。更换为高速串行主机接口时,SerDes 和速率转换不能凭“宽而慢”的名称被消掉。Avicena 在 2025 年 8 月的公开演示中也区分了现有 PAM4 接口与未来并行接口的系统代价。[2,第 11 页]
热同样不是独立的小问题。原论文报告,在硅 IC 上约 5 kA/cm² 驱动时观察到约 50°C 温升。这是具体实验现象,不是器件允许的最高结温。增加通道数后,需要测阵列中心、边缘和邻近电路的温度分布,而不是只把单颗 LED 的平均功耗乘以数量。
5. 下一步该做什么实验?
对这条路线,最有信息量的工作不是再找一个最好单通道,而是做受控的层层替换。
第一步,固定同一颗 MicroLED、同一光路和温度,比较参考接收器与集成接收器的灵敏度、输入电容和频响,定位速度损失发生在探测器还是 TIA。
第二步,保持接收器与速率不变,从单通道、邻居开启到全阵列开启,分别测试静态负载、不同 PRBS 和同步翻转。结合电源噪声、光功率和温度测量,将电学、光学与热影响分开。必要时用遮断光路但保持电路工作的对照,识别只看 BER 无法分辨的耦合来源。
第三步,把实验室均衡移入实际驱动电路,报告同一 BER 目标下的总功耗、峰值电流、摆幅和时序裕量。只有完成这一步,单器件高速能力才真正变成可集成的通道能力。
最后,所有低 BER 数字都应配测试时长、发送比特数和纠错口径。若假设误码独立且统计稳定,零误码时的 95% 单侧上界约为 3/N;要支持 BER 小于 10⁻¹²,约需 3×10¹² bit。按 2.5 Gb/s 计算,约需 1,200 秒,即 20 分钟。这个计算只是测试设计示例;突发误码、环境漂移及多通道相关性仍需额外实验,不能靠延长一次测试完全覆盖。
这也给出了进入这条技术路线的一种实在机会:把参考仪器上的结果迁移成可复现的阵列验证流程,建立统一的通道编号、光电参考面、温度和功耗记录。外延、封装和 ASIC 团队之间真正缺少的,往往是能把“哪里变好了”与“系统为什么还没变好”连接起来的证据。
下一篇进入另一条路线:GaN-on-Si 同质收发:为什么会发光的器件,未必接得住自己的光?
来源与适用边界
- B. Pezeshki,GaN Micro-LEDs for Chip-to-Chip Interconnects,CS MANTECH 2025,Paper 10A.1。本文按实验配置解读厂商研究人员公开的原始论文,未将其视为独立第三方认证。原始 PDF
- Avicena,Micro-LED data interconnects / Transforming connectivity with ultra-fast µLEDs,2025-08-22。本文只引用第 11 页对 PAM4 与并行接口的架构区分,不把其他页的商业预测作为实测。公开演示 PDF
核对日期:2026-09-17。以上是对指定历史实验的独立技术解读,不是对 2026 年全部商业产品性能的排名。原图为本文分析所需的局部引用,版权归原作者或权利人;保留原图注与数据,中文评论单独呈现,不代表作者或机构对本文的背书。