80 fJ/bit 到底算了什么:MicroLED 完整链路功耗账本
80 fJ/bit 与整个端口功耗有什么关系?用原始 BER 曲线、功耗分解和可复算账本,区分 LED、驱动、接收、接口及有效数据的计量边界。
MicroLED 光互连 · 技术难点深读。原始证据与独立分析分开呈现,点击原图可查看大图。
看到“80 fJ/bit”,很容易把它理解成:每把一个比特送到对面,整套系统只消耗 80 飞焦耳。但这个理解跨过了最重要的问题:电表接在哪里,比特数在哪里统计?
MicroLED 的低器件能耗值得认真研究。不过,真正决定产品是否省电的,不只是发光二极管,而是 LED、驱动器、接收器、接口电路与空闲管理共同构成的账本。
1. 80 fJ/bit 是一个很窄、但有价值的结果
Avicena 在 2025 年 11 月 17 日公告中报告:单通道 4 Gb/s、每颗 LED 电流低至 100 µA,raw BER 为 1×10⁻¹²,不使用 FEC,并给出 80 fJ/bit per LED。这是厂商发布的结果,不是本文独立复测。公告还指出,改进高灵敏度接收器,使所需 LED 电流进一步降低。原始公告
关键限制是:公告没有完整列出这个数字覆盖哪些驱动电源轨、接收器和接口,也没有交代 100 µA 是平均值、偏置值还是其他电流定义。不能据此把 80 fJ/bit 写成“整个收发链路实测功耗”,也不能反推一个已验证的 LED 工作电压。
可以做的确定运算只有:80 fJ/bit × 4 Gb/s = 0.32 mW。这是按公告口径换算的每颗 LED 对应功率;不是完整端口功率。
2. 原论文已经给过一次边界提醒
另一项容易混淆的结果来自 Pezeshki 的 CS MANTECH 2025 论文:把 MicroLED 转移到被动蓝宝石测试载片,使用外部 AC 耦合 50 Ω 驱动及一抽头 FIR 均衡,考察 10 Gb/s NRZ。下面是原文跨两页排版的同一幅 Fig.6。
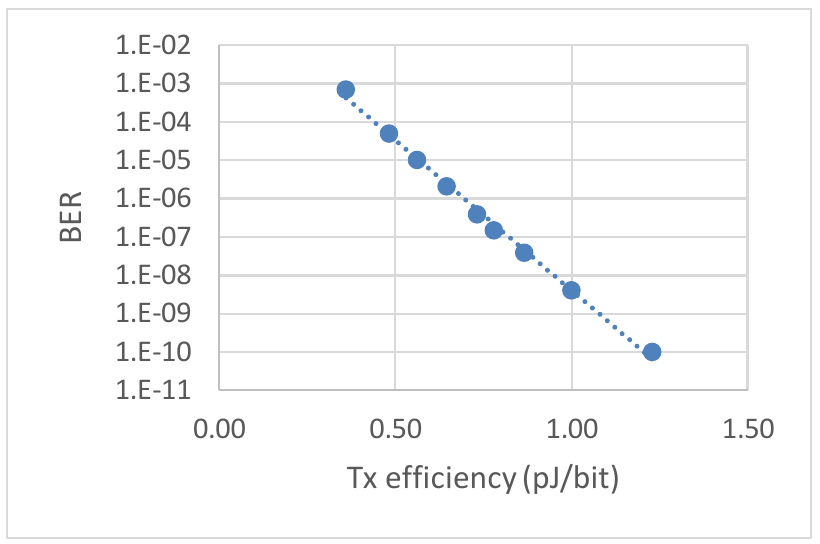
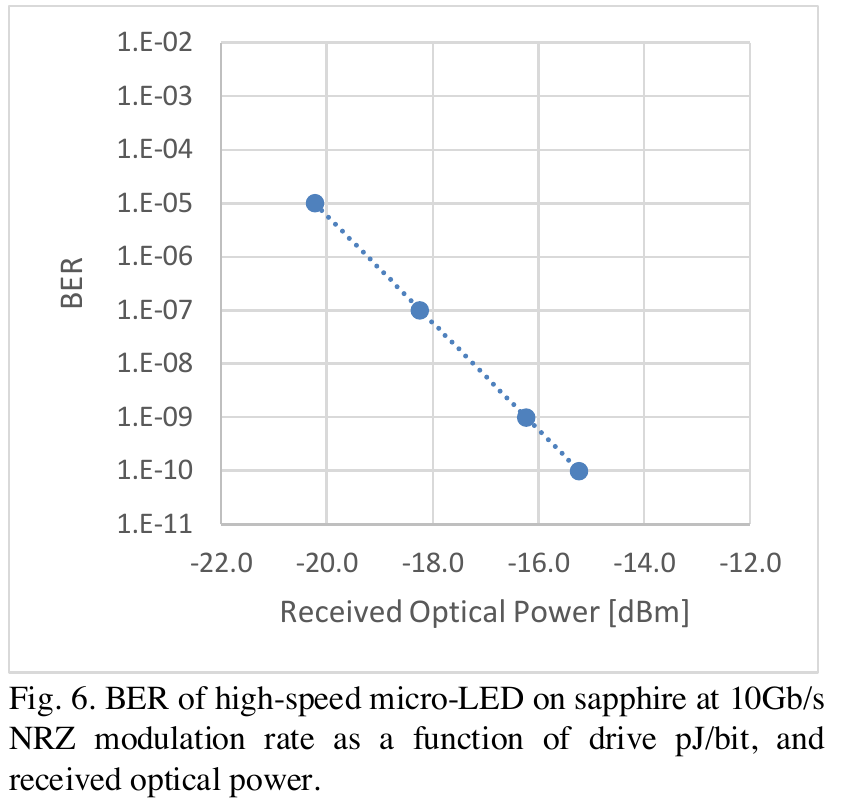
图上约 1.2 pJ/bit 对应 BER 约 10⁻¹⁰;这是图上估读,不是假装有原始数表的精确值。更重要的是第 3 页的方法说明:作者用平均电流乘电压得到功率,再按速率归一化;如果计入集成驱动器,预计还会增加约 20%。“预计增加”不是已经完成的 ASIC 功耗测量。
同一论文另有集成接收电路约 0.35 pJ/bit 的描述,但实验结构、速率与这张图不同。不能把 80 fJ、这里的“加 20%”和 0.35 pJ 三个最好数字拼成一个不存在的完整链路规格。Pezeshki 2025,第 2–4 页
3. 一条链路至少需要六行账
| 账本层级 | 必须计入什么 | 最容易遗漏什么 |
|---|---|---|
| LED 本体 | 端口电压与电流的时间平均功率 | “0”电平偏置、不同数据模式 |
| 发射端 Tx | LED 加驱动器、预加重、偏置和电平转换 | 输出级压降、终端电阻、驱动器静态电流 |
| 接收端 Rx | PD 偏置、TIA、限幅/判决与均衡 | APD 高压供应、暗电流、持续开启的模拟前端 |
| 接口与时钟 | SerDes、gearbox、PLL/CDR、时钟分配 | 主机侧高速接口仍然存在 |
| 协议与维护 | FEC/ECC、训练、校准、冗余通道、重传 | 额外通道消耗功率却不增加 payload |
| 供电与运行状态 | DC/DC 损耗、控制器、空闲、唤醒 | 用满载峰值速率去除低利用率平均功率 |
这些行不能重复相加。例如,电表若已测到整个 Tx 芯片电源输入,再把 LED 功率加一次就会重复。被动 PD 不等于接收端零功耗;光纤本身不耗电,也不等于光纤两端的电路不耗电。
统一口径可以写成:
一定要同时声明单向还是双向、是否两端都计电、是否含主机接口。两只收发器的功率除以单向 800 Gb/s,与除以双向合计 1.6 Tb/s,不是同一个指标;不能差一个二倍因子却用同一名称比较。
4. MOSAIC 为什么仍然有瓦级账单?
MOSAIC 的 Fig.8 恰好把漏掉的层次画出来。下图不是“LED 比别的光源多耗电”,而是在回答更大边界的问题。
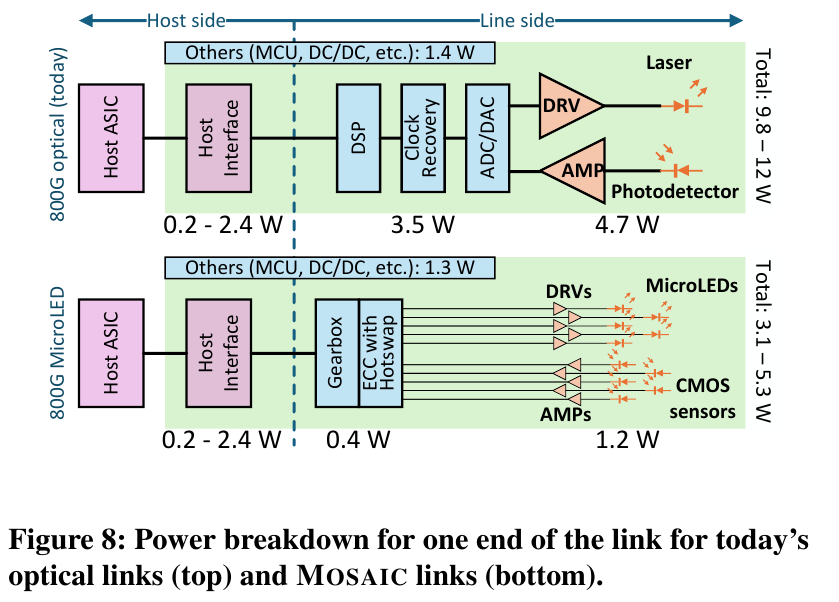
作者估算单端 MicroLED 加模拟前端为 1.2 W,gearbox 与轻量故障保护为 0.4 W,MCU、DC/DC 等为 1.3 W,主机接口为 0.2–2.4 W,总计 3.1–5.3 W/端。因此,两端是 6.2–10.6 W;这仍不是主机加网络加冷却的整机账单。MOSAIC,§5
这里的机制很明确:少做高速串行化、复杂均衡与时钟恢复,能降低电子电路成本;但兼容现有高速主机接口,就还需要接口和速率转换。Wide-and-slow 并不自动等于“从主机到主机没有任何 SerDes”。
另一个常见误读是“无 FEC”。MOSAIC 没有新增传统高复杂度线路 FEC,不等于抛弃主机协议既有 FEC;论文 §4.1 明确保留上层 PCS 的 FEC 保护,并提出跨通道轻量 ECC 与热备。其 400 数据通道加 60 校验通道的示例,校验开销是 15%,而不是新增 15% 用户吞吐。MOSAIC,§4.1
5. 驱动器为什么不是一根理想导线?
驱动器既要提供 LED 正向压降所需的电压余量,又要快速建立调制电流。输出级的余量电压乘电流会发热;提高电源并不保证更多电能变成光。pad、键合、走线和 LED 结电容还要反复充放电,动态开销随有效电容、摆幅平方和转换活动增加。
减小 die 和缩短互连可以降电容,但更小 LED 的总出光能力、边缘复合和局部电流密度又可能恶化。预加重能补高频衰减,却可能增加峰值电流、驱动摆幅及热负担。因此,判断一个转移/键合方案是否省电,应在同一接收 BER、同一温度和光学损耗下比较,而不是只看互连更短。
NRZ、PAM4、OFDM 的能耗差异也不能只按“每个符号带几位”判断:
- NRZ:两级驱动与判决可以简单;如果靠很高电流和强预加重硬推速度,优势会缩小。
- PAM4:同一原始比特率下符号率减半,但四个光功率电平要可区分,线性度、噪声和电平校准更严格;不一定必须使用通用高分辨率 DAC/ADC,具体电路实现决定开销。
- OFDM:可按频段分配比特,利用带宽有限的器件;但常见实现需要多电平波形、DAC/ADC 和 FFT。峰均比、偏置与削顶会限制 LED 的可用动态范围,离线示波器解调不能作为低功耗接收 ASIC 的证明。
正确的优化目标是:在相同净吞吐、BER、距离与温度条件下,总功率最低。更灵敏的 PD/TIA 能省 LED 电流,但如果增加的接收功率大于省下的 Tx 功率,就没有系统收益。
6. 一个可复算的假想账本
以下完全是教学假设,不是 Avicena 或 MOSAIC 的规格:256 条物理通道,每条 4 Gb/s;其中 224 条承载用户数据,32 条用于校验等开销;数据通道再扣除 10% 协议开销。满载有效吞吐为 224 × 4 × 0.90 = 806.4 Gb/s。
假设每条物理通道的 LED、driver、Rx 分别耗能 0.08、0.12、0.35 pJ/物理比特。全通道动态功率为 256 × 4 × 0.55 mW = 0.5632 W。再假设未重复计入的共享接口、时钟、供电损耗等合计 0.8 W。
| 运行假设 | 总功率 | 成功交付 payload | 能耗 |
|---|---|---|---|
| 满载 | 1.3632 W | 806.4 Gb/s | 1.69 pJ/bit |
| 25% 利用率,电路仍全部开启 | 1.3632 W | 201.6 Gb/s | 6.76 pJ/bit |
| 25% 利用率,可变部分理想按比例降低 | 0.9408 W | 201.6 Gb/s | 4.67 pJ/bit |
最后一行是理想缩放假设,未扣除关断/唤醒成本,不是已验证机制。真实时钟、热备和控制通道可能必须常开。
更有启发性的是:把 LED 的 0.08 pJ/bit 再减半,总功率只少 0.04096 W,约减少满载总功率的 3.0%。这不是说 LED 优化不重要,而是说明当它已经很省电时,驱动、接收器、接口和低利用率管理可能更值得优先攻克。
7. 怎样验证一个“超低功耗链路”?
测试应固定 payload、距离、接收 BER 与温度,再同时测 Tx/Rx 电源轨和端口吞吐;分别记录 LED 支路、driver、Rx、接口及 DC/DC,检查分项和总电表是否闭合。模式至少覆盖满载 PRBS、真实短包、25% 负载、空闲和唤醒;记录编码、重传、开启通道数及电流定义。
若声称不需要 FEC,就给出对应 BER 的统计窗口。独立误码近似成立时,零误码测量要将 BER 的 95% 置信上界压到 10⁻¹²,大约需观察 3×10¹² bit;4 Gb/s 单通道约需 750 秒。突发错误和相关性还需要更长、更贴近运行条件的测试,不能只交付一张开眼图。
读完一个能耗数字后,值得追问的不是“还能不能更低”,而是:在什么电表边界、什么有效数据率、什么错误保证下更低?为了少发一点光,系统其他地方多花了多少电?
引用与说明
本文为独立技术分析,测量、仿真、作者估算、公司公告与教学假设分别标注。第三方原图只用于直接讨论其数据、结构和边界,版权仍归原权利人;开放许可按图注执行,其他局部引用不代表取得通用转载授权。未上传完整论文或受限调研报告,内容不代表原作者、出版商、机构或雇主意见。