AI 的数据到底卡在哪里:从内存墙到 MicroLED 光互连
直接读论文增长曲线和 NVIDIA 原始规格表,区分显存容量、显存带宽与 GPU 间通信,判断 MicroLED 光互连真正能改善哪一段。
MicroLED 光互连 · 基础篇 01。这个系列从系统需求出发,逐步进入器件、光学、封装和测试。本文只回答一个问题:数据搬运卡在哪里,光互连能改善其中哪一段?
一台装满 GPU 的机器,仍可能有很多时间在等数据。看到这个现象,直接得出“换成光互连就会更快”,中间还缺一次诊断。
数据可能装不进显存,可能来不及从显存送入计算单元,也可能卡在 GPU 之间的交换。三个问题会同时出现,但对应的解决方法不同。理解这一层,才知道 MicroLED 光互连为什么值得研究,以及它的作用边界在哪里。
先读原始曲线:增长速度为什么拉开了?
Gholami 等人在《AI and Memory Wall》中,把历史硬件的峰值算力、DRAM 带宽和互联带宽放在同一张归一化图中。下面直接引用论文原图,保留坐标、图例与图注。
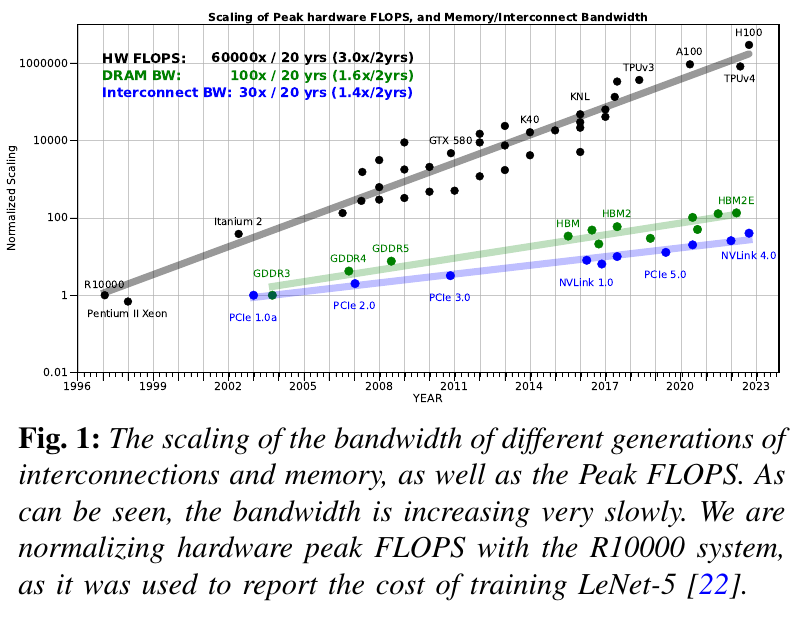
读这张图,先看斜率,再看倍数。黑色曲线比绿色和蓝色更陡,说明计算能力与供数能力的演进并不同步。它提出了一个系统问题:计算单元越来越能算,数据能否及时到达?
这里不能把黑线与蓝线相除,声称某一代 GPU 有固定比例的算力被浪费。图中混合了不同硬件世代,峰值算力还涉及数值精度、计算类型和体系结构;实际利用率必须回到具体任务测量。历史增长曲线适合说明研究动机,应用性能需要另外建立证据。
“内存墙”至少有三种不同的堵点
把一次运算沿数据路径拆开,问题会清楚得多。
| 堵点 | 要回答的问题 | 典型现象 | 优先检查什么 |
|---|---|---|---|
| 显存容量 | 工作集能否放得下? | 分配失败、频繁卸载、必须拆到更多 GPU | 权重、激活、KV cache、优化器状态各占多少空间 |
| 显存带宽 | 数据能否及时从 HBM 送到计算单元? | 模型装得下,计算单元仍在等数据 | 每步实际读取字节数、HBM 吞吐、缓存命中与数据复用 |
| GPU 间通信 | 划分后的任务能否及时交换数据? | 增加 GPU 后加速变差,通信或同步进入关键路径 | 消息大小、通信频次、拓扑、拥塞、尾部延迟与通信重叠 |
这是一张诊断表,不是硬件优劣排名。容量足够,并不能保证带宽足够;端口带宽很高,也不能保证集合通信能够持续吃满。
一个常见误区是把“HBM 带宽”和“GPU 间互联带宽”称作同一种带宽。它们服务于不同的数据路径。下面看一份具体规格。
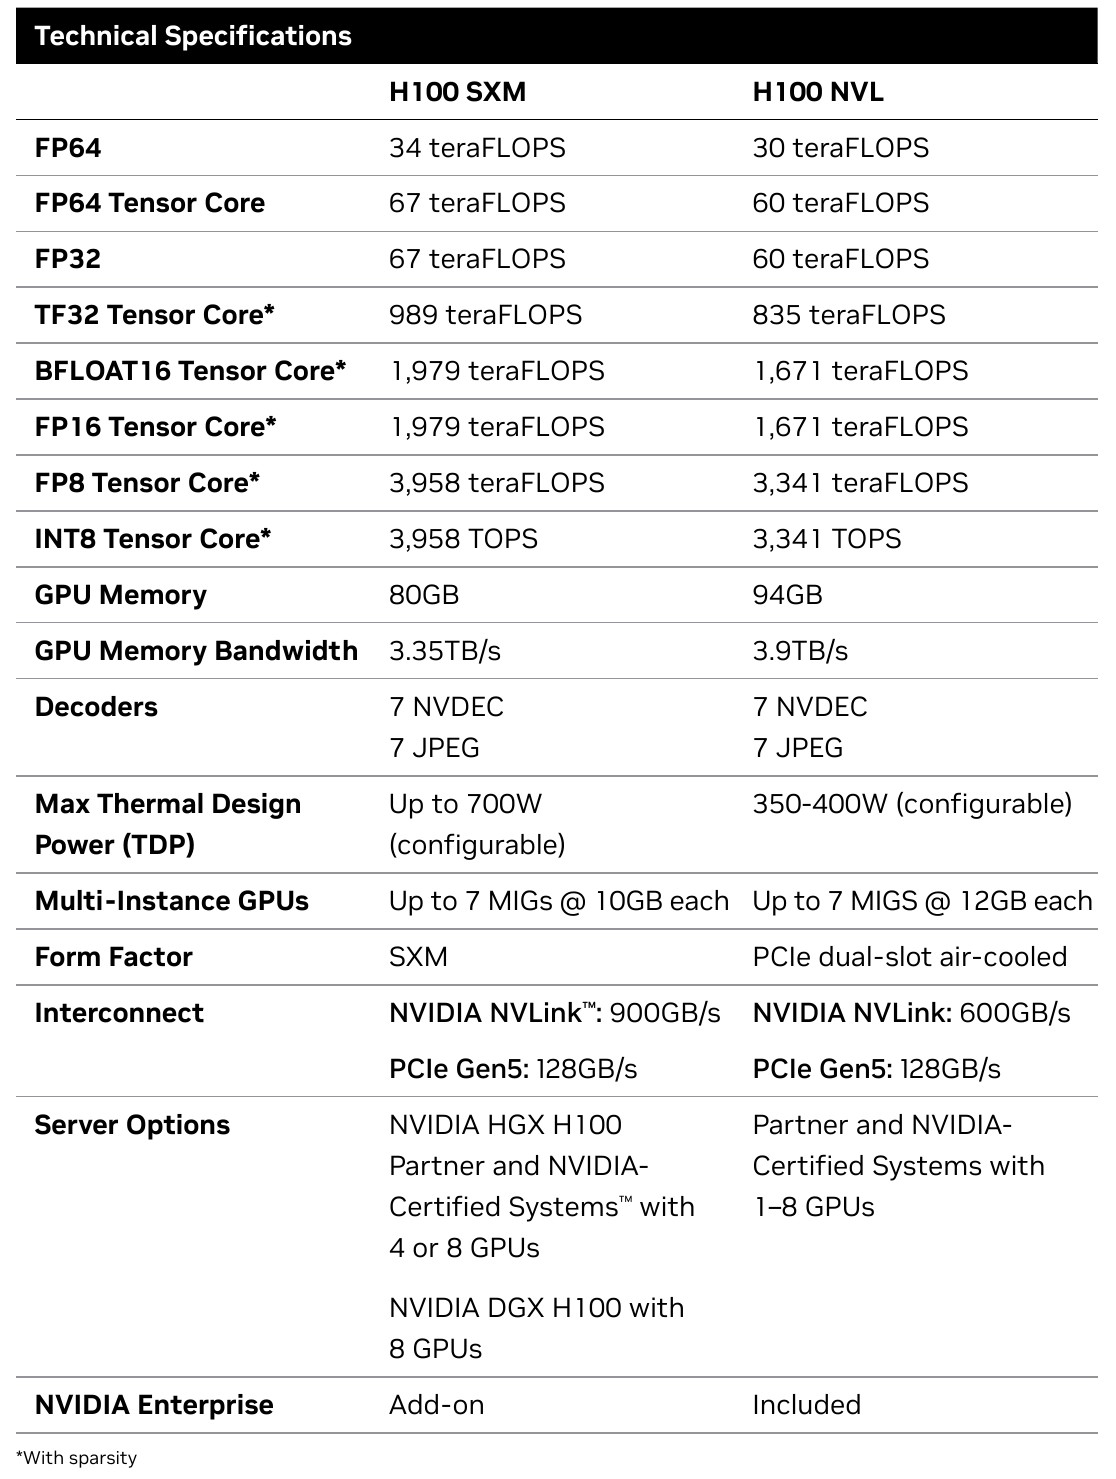
只取这张表中 H100 SXM 一列的三个数,就能建立清楚的层次:
| 指标 | 原表值 | 在系统中意味着什么 |
|---|---|---|
| GPU Memory | 80 GB | 容量,回答能装多少数据 |
| GPU Memory Bandwidth | 3.35 TB/s | 显存接口峰值带宽,回答本地数据搬运的能力 |
| NVLink | 900 GB/s | 每 GPU 双向聚合互联带宽,回答与其他 GPU 交换数据的接口能力 |
NVLink 的双向口径可在同份资料第 3 页核对。不能把 900 GB/s 当成一次单向传输的可用吞吐量,也不能把 3.35 TB/s 与它直接相除,得到应用必然变慢的倍数。还有一点同样重要:表中 SXM 与 NVL 是不同配置,不能从两列各选最好值拼出一种不存在的设备。NVIDIA 架构说明
一个小算例:装得下,为什么还会等?
设一个模型有 70 亿个参数,每个参数占 2 字节,只计算权重,就需要约 14 GB。这个大小低于上表的 80 GB,但这里只回答了容量问题;实际运行还需要其他状态和缓存。
再作一个刻意简化的假设:某一步需要从 HBM 读一遍全部权重,没有缓存复用,并且能持续达到 3.35 TB/s。则仅权重读取的理想时间下界为:
14 GB ÷ 3,350 GB/s ≈ 4.18 ms。
这是作者计算示例,不是 H100 的 token 延迟测试。它忽略了计算、KV cache、其他读写和调度,也没有声称每种推理方式都会逐步读完整个模型。它要说明的只是:即使数据放得下,供数仍有时间成本。
提高批量、融合算子或改善缓存复用,有机会让一次读取服务更多计算,代价可能是额外的等待时间、显存占用或实现复杂度。这类优化应先在本地数据路径上验证。若工作负载始终被本地 HBM 读取限制,升级 GPU 之间的线缆不会自动解除这个限制。
MicroLED 光互连进入的是哪一段?
当任务跨 GPU 划分后,激活、梯度或其他中间结果需要跨芯片传递。此时,互联的带宽、延迟、距离、能耗和布线空间,会影响系统可以采用怎样的拓扑与规模。
MicroLED 链路尝试通过大量并行光通道,把信号从一个电端点送到另一个电端点。光源只完成这条路径的一部分,完整系统仍需要电接口、驱动、耦合光学、传输介质、探测器和接收电路。此前的宽而慢架构入门已经讨论通道组织;这里更关心它是否击中了任务的瓶颈。
判断收益,可以先在应用时间线上做一个算例。假设某一步总耗时 100 ms,其中 40 ms 是计算,60 ms 是无法被计算覆盖的通信等待。如果某个链路改进把这 60 ms 降为 30 ms,总耗时就是 70 ms,加速约 1.43 倍。
这也是作者计算示例。这里没有把链路吞吐提高一倍直接等同于应用加速一倍;通信中还有启动、同步、排队等不一定随带宽等比例减少的部分。如果通信原本已被计算充分覆盖,即使链路更快,墙钟时间的变化也可能很小。
怎样证明链路改进对应用有效?
对想进入这个方向的工程师,一项有价值的能力是把器件指标连接到系统测量。可以从以下四组证据开始:
| 测量层次 | 固定条件 | 观察量与判断 |
|---|---|---|
| 本地显存 | 模型、精度、批量、序列长度一致 | HBM 吞吐和数据复用;确认是否先被本地带宽限制 |
| 点到点链路 | 消息大小、方向、距离和并发数一致 | 有效吞吐、延迟分布、重传或错误;不只报线速 |
| 多端点通信 | GPU 数、拓扑和通信算法一致 | 集合通信耗时、拥塞和最慢端点;找扩展后的尾部问题 |
| 完整应用 | 软件、精度、任务量和计时范围一致 | 每步耗时或满足延迟约束的吞吐,以及对应系统能耗 |
更换链路前后都保留这四层记录,就能区分三件事:器件是否变好、通信是否变快、应用是否真正受益。若只展示光源每比特能耗,却没有接收端和电接口功耗,仍无法完成系统比较。
这也是本文留下的判断方法:先找出数据等待发生的位置,再讨论哪种互联值得采用。光互连的机会需要落在一条具体的数据路径上,最终用应用结果验证。
下一篇:铜线为什么越跑越吃力:从 1.5 米实测看 MicroLED 光互连的切入点。我们把视角从任务时间线移到物理通道,直接比较同一设计的仿真与实测曲线。
资料与口径
- Gholami, A. 等,AI and Memory Wall,arXiv:2403.14123v1,2024。本文引用 Fig. 1 的历史趋势,未将其外推为 2026 年产品预测。论文与版本信息
- NVIDIA,H100 Tensor Core GPU Datasheet,文档号 3440270,SEP24。原表见 PDF 第 2 页,NVLink 双向说明见第 3 页。原始 PDF
- NVIDIA,NVIDIA Hopper Architecture In-Depth,2022。架构说明
本文两幅图片均为公开一手资料中用于逐图分析的必要原始节选,版权归原作者或机构;其余诊断表和算例为作者分析。资料核对日期:2026-09-17。